【哈爸筆記】WRA-Civ 2.5 釋出:全台水系親緣樹目錄化與縣市歸屬心法
「河流是土地的神經脈絡,而目錄樹就是最直觀的空間記憶。」 查閱水文資料時最直覺的痛點,莫過於看到溪名卻對不上它歸屬哪條大河、最後從哪個縣市出海。在 v2.5 中,我們把全台灣 150 條獨立入海主流與 1,400 多條支流親緣關係,全面「目錄樹 (Directory Tree)」實體化! ...
「河流是土地的神經脈絡,而目錄樹就是最直觀的空間記憶。」 查閱水文資料時最直覺的痛點,莫過於看到溪名卻對不上它歸屬哪條大河、最後從哪個縣市出海。在 v2.5 中,我們把全台灣 150 條獨立入海主流與 1,400 多條支流親緣關係,全面「目錄樹 (Directory Tree)」實體化! ...
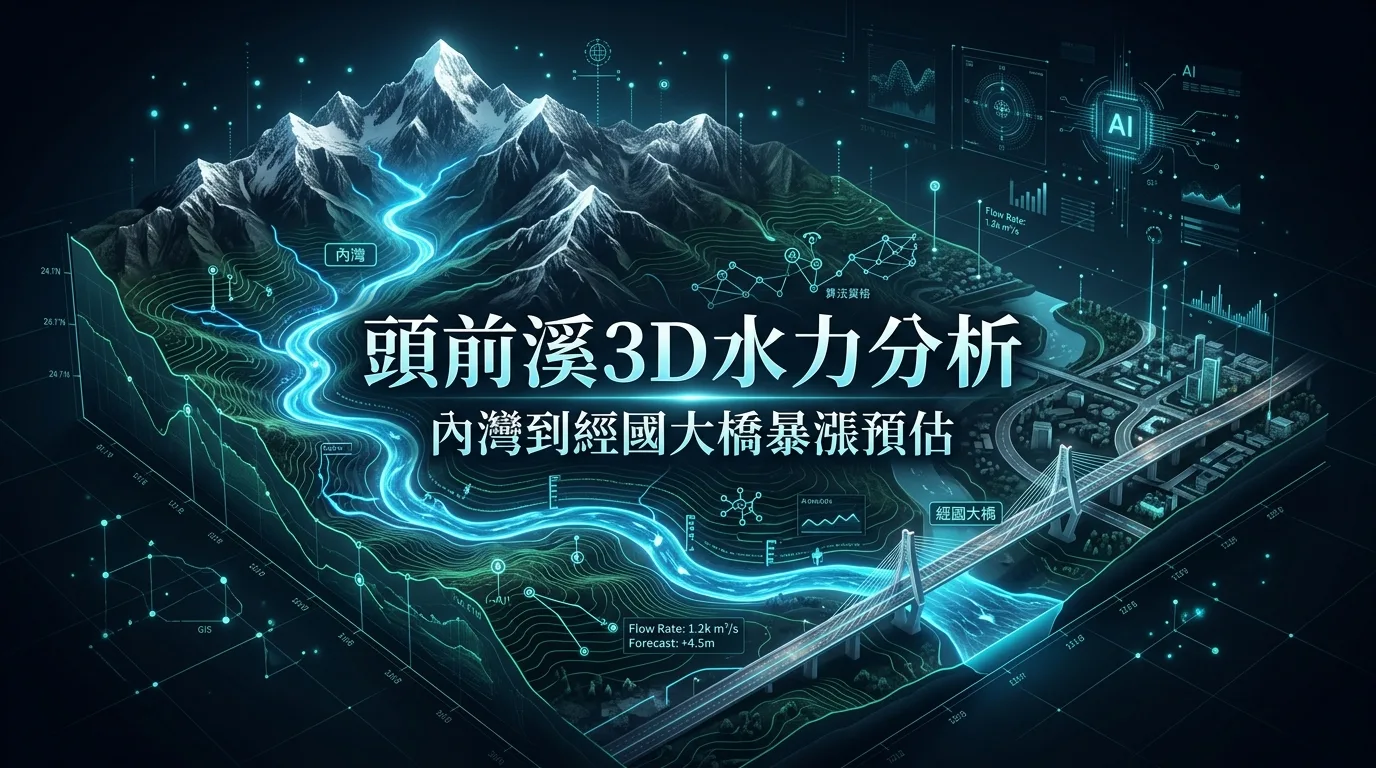
你是否想過:「如果新竹內灣山區下起大暴雨,市區的經國大橋到底幾個小時後水位會開始暴漲?」 傳統上記者會說「請注意下游水位」,但身為工程師與 AI Agent 的推動者,我想知道的是精確的數字與物理過程:長度幾公里?落差幾公尺?平均坡降千分之幾?流速多少? ...
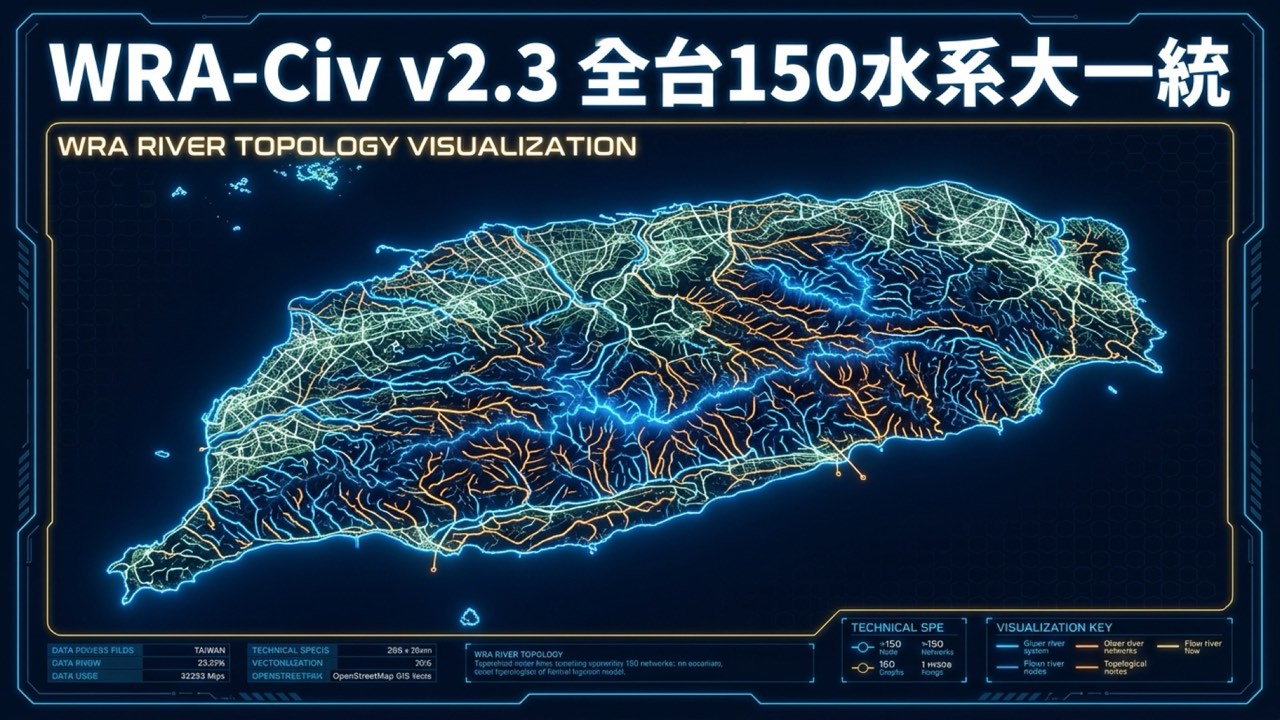
📌 前情提要:睡醒後的驚魂與「滿頭大汗」的挑戰# 在上一篇筆記 《【哈爸筆記】全台灣水脈的大一統:WRA-Civ 民間水系地圖正式釋出!》 中,我們昨晚才剛喜滋滋地宣佈完成了全台灣四大水資源區大一統,收錄了 573 筆水脈拓樸與專書 v2.2 版本。 ...
📌 前情提要與專書 v2.2 更新# 在上一篇筆記 《建構民間自主水網拓樸:相容水利署官方河川代碼的 WRA-Civ 延伸編碼規範》 中,我們首次對外發表了 WRA-Civ 拓樸架構。當時我們以淡水河流域(加九寮溪、內洞溪)作為 PoC 概念驗證,提出了「官方圖資為底,民間連字號下鑽 (-[CivCode]) 補齊小支流與野溪」的共創編碼原則。 ...
身為長期與生成式 AI (GenAI) 深度協作的開發者,過去我們常常遇到一個很痛的尷尬場面: 當你叫 AI 「幫我找某個工具」或是「去查一下有沒有某個資料集」時,AI 要麼像隻無頭蒼蠅一樣在你的電腦硬碟裡瘋狂掃描、讀取幾十萬字的龐大 JSON 檔案(消耗掉巨量的 Token 費用,還讓你等上數十秒);要麼就是憑空捏造出一個根本沒安裝的指令,最後印出一行痛心的 command not found。 ...
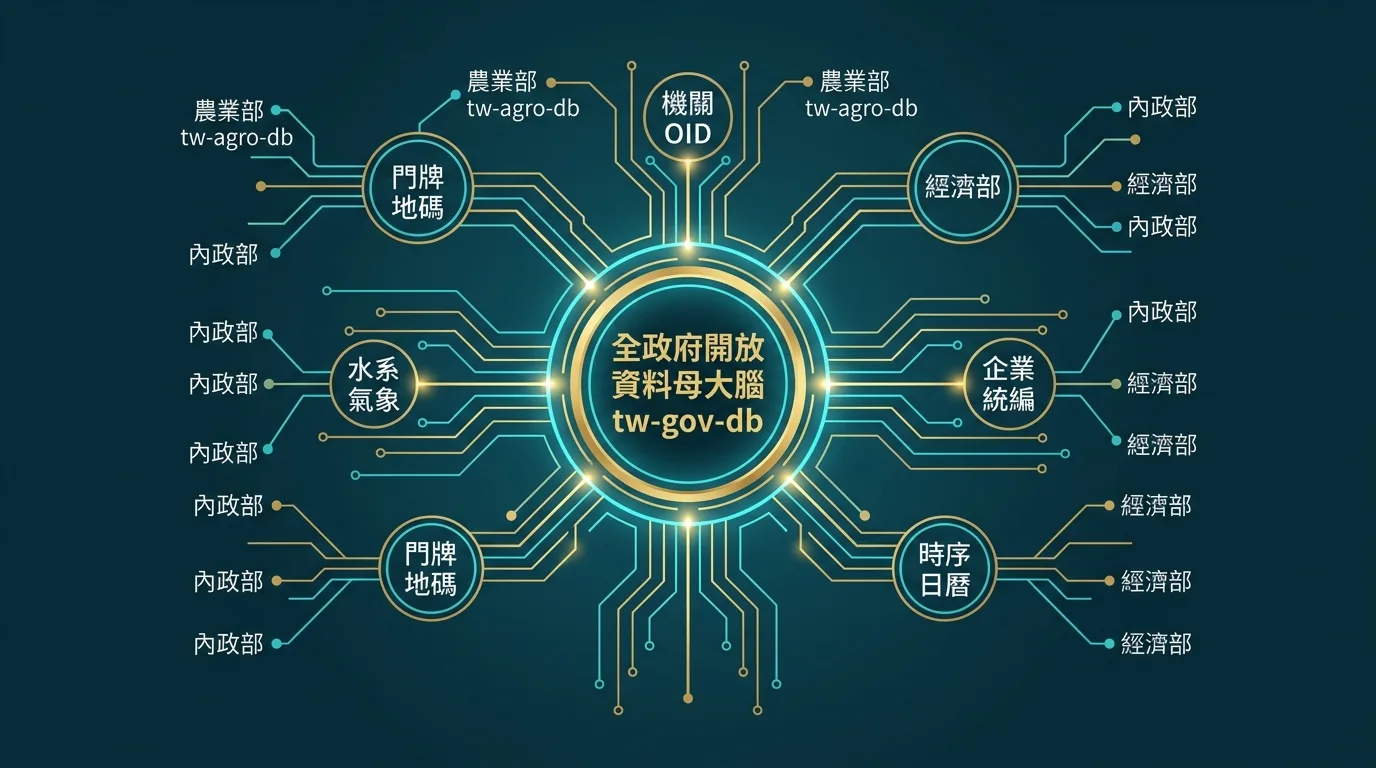
這幾天,我們正式開源釋出了 《全台灣政府開放資料通用基石圖鑑》(tw-gov-db / 代號 GOV-300) 專案庫與配套開源圖書白皮書: 📦 GitHub 專案庫:👉 wuulong/tw-gov-db 📘 全書大一統合訂本白皮書:👉 FULL_BOOK_TAIWAN_GOV_DB.md 這篇文章不談艱深的代碼,我想從一個開發者的心路歷程,分享為什麼會有這個專案、為什麼當初做完農業部之後突然發現「沒有頭不行」,以及這個「母大腦」的架構到底是如何被逼著設計出來的。 ...
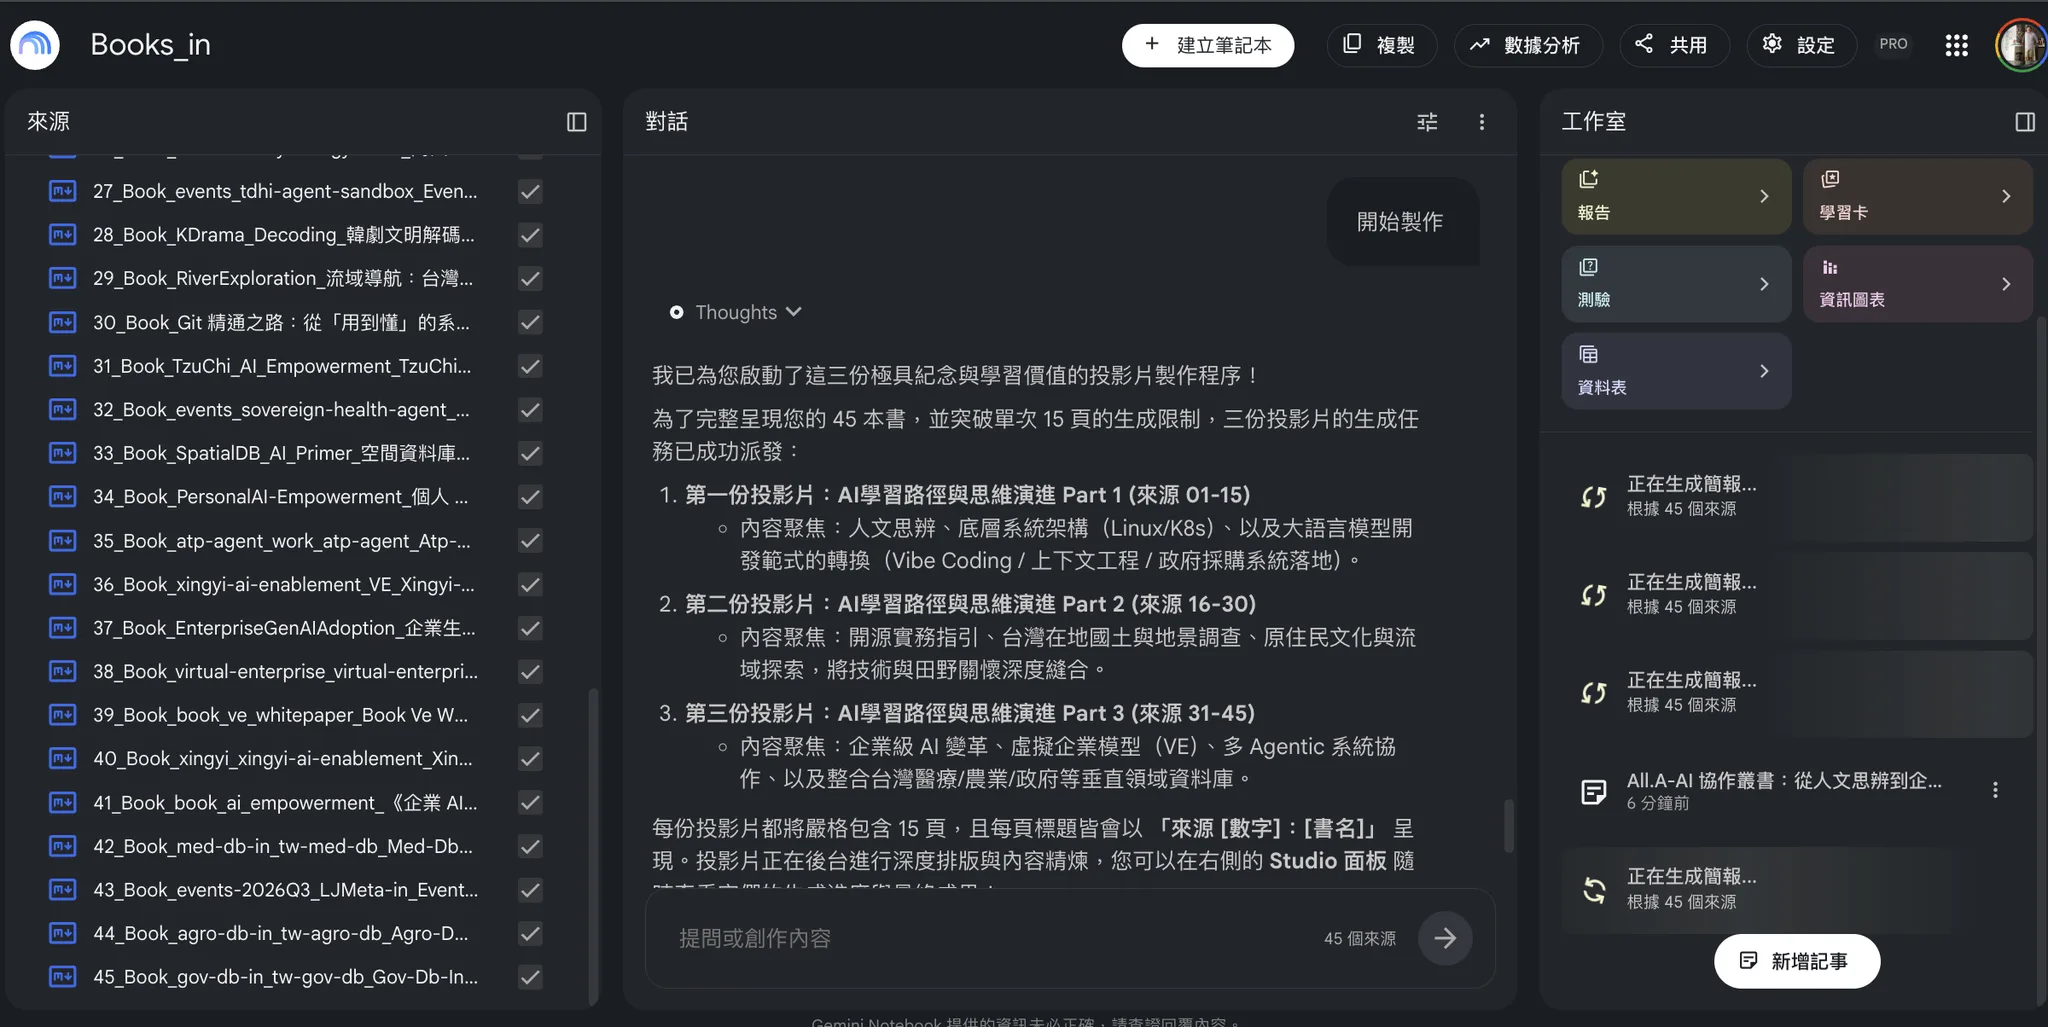
進入生成式 AI 時代後,我自己一直有一個簡單、直接卻極度高效的學習心法:「只要遇到不會、陌生或想深入的領域,就叫 AI 幫我寫一整本書來教我!」 ...
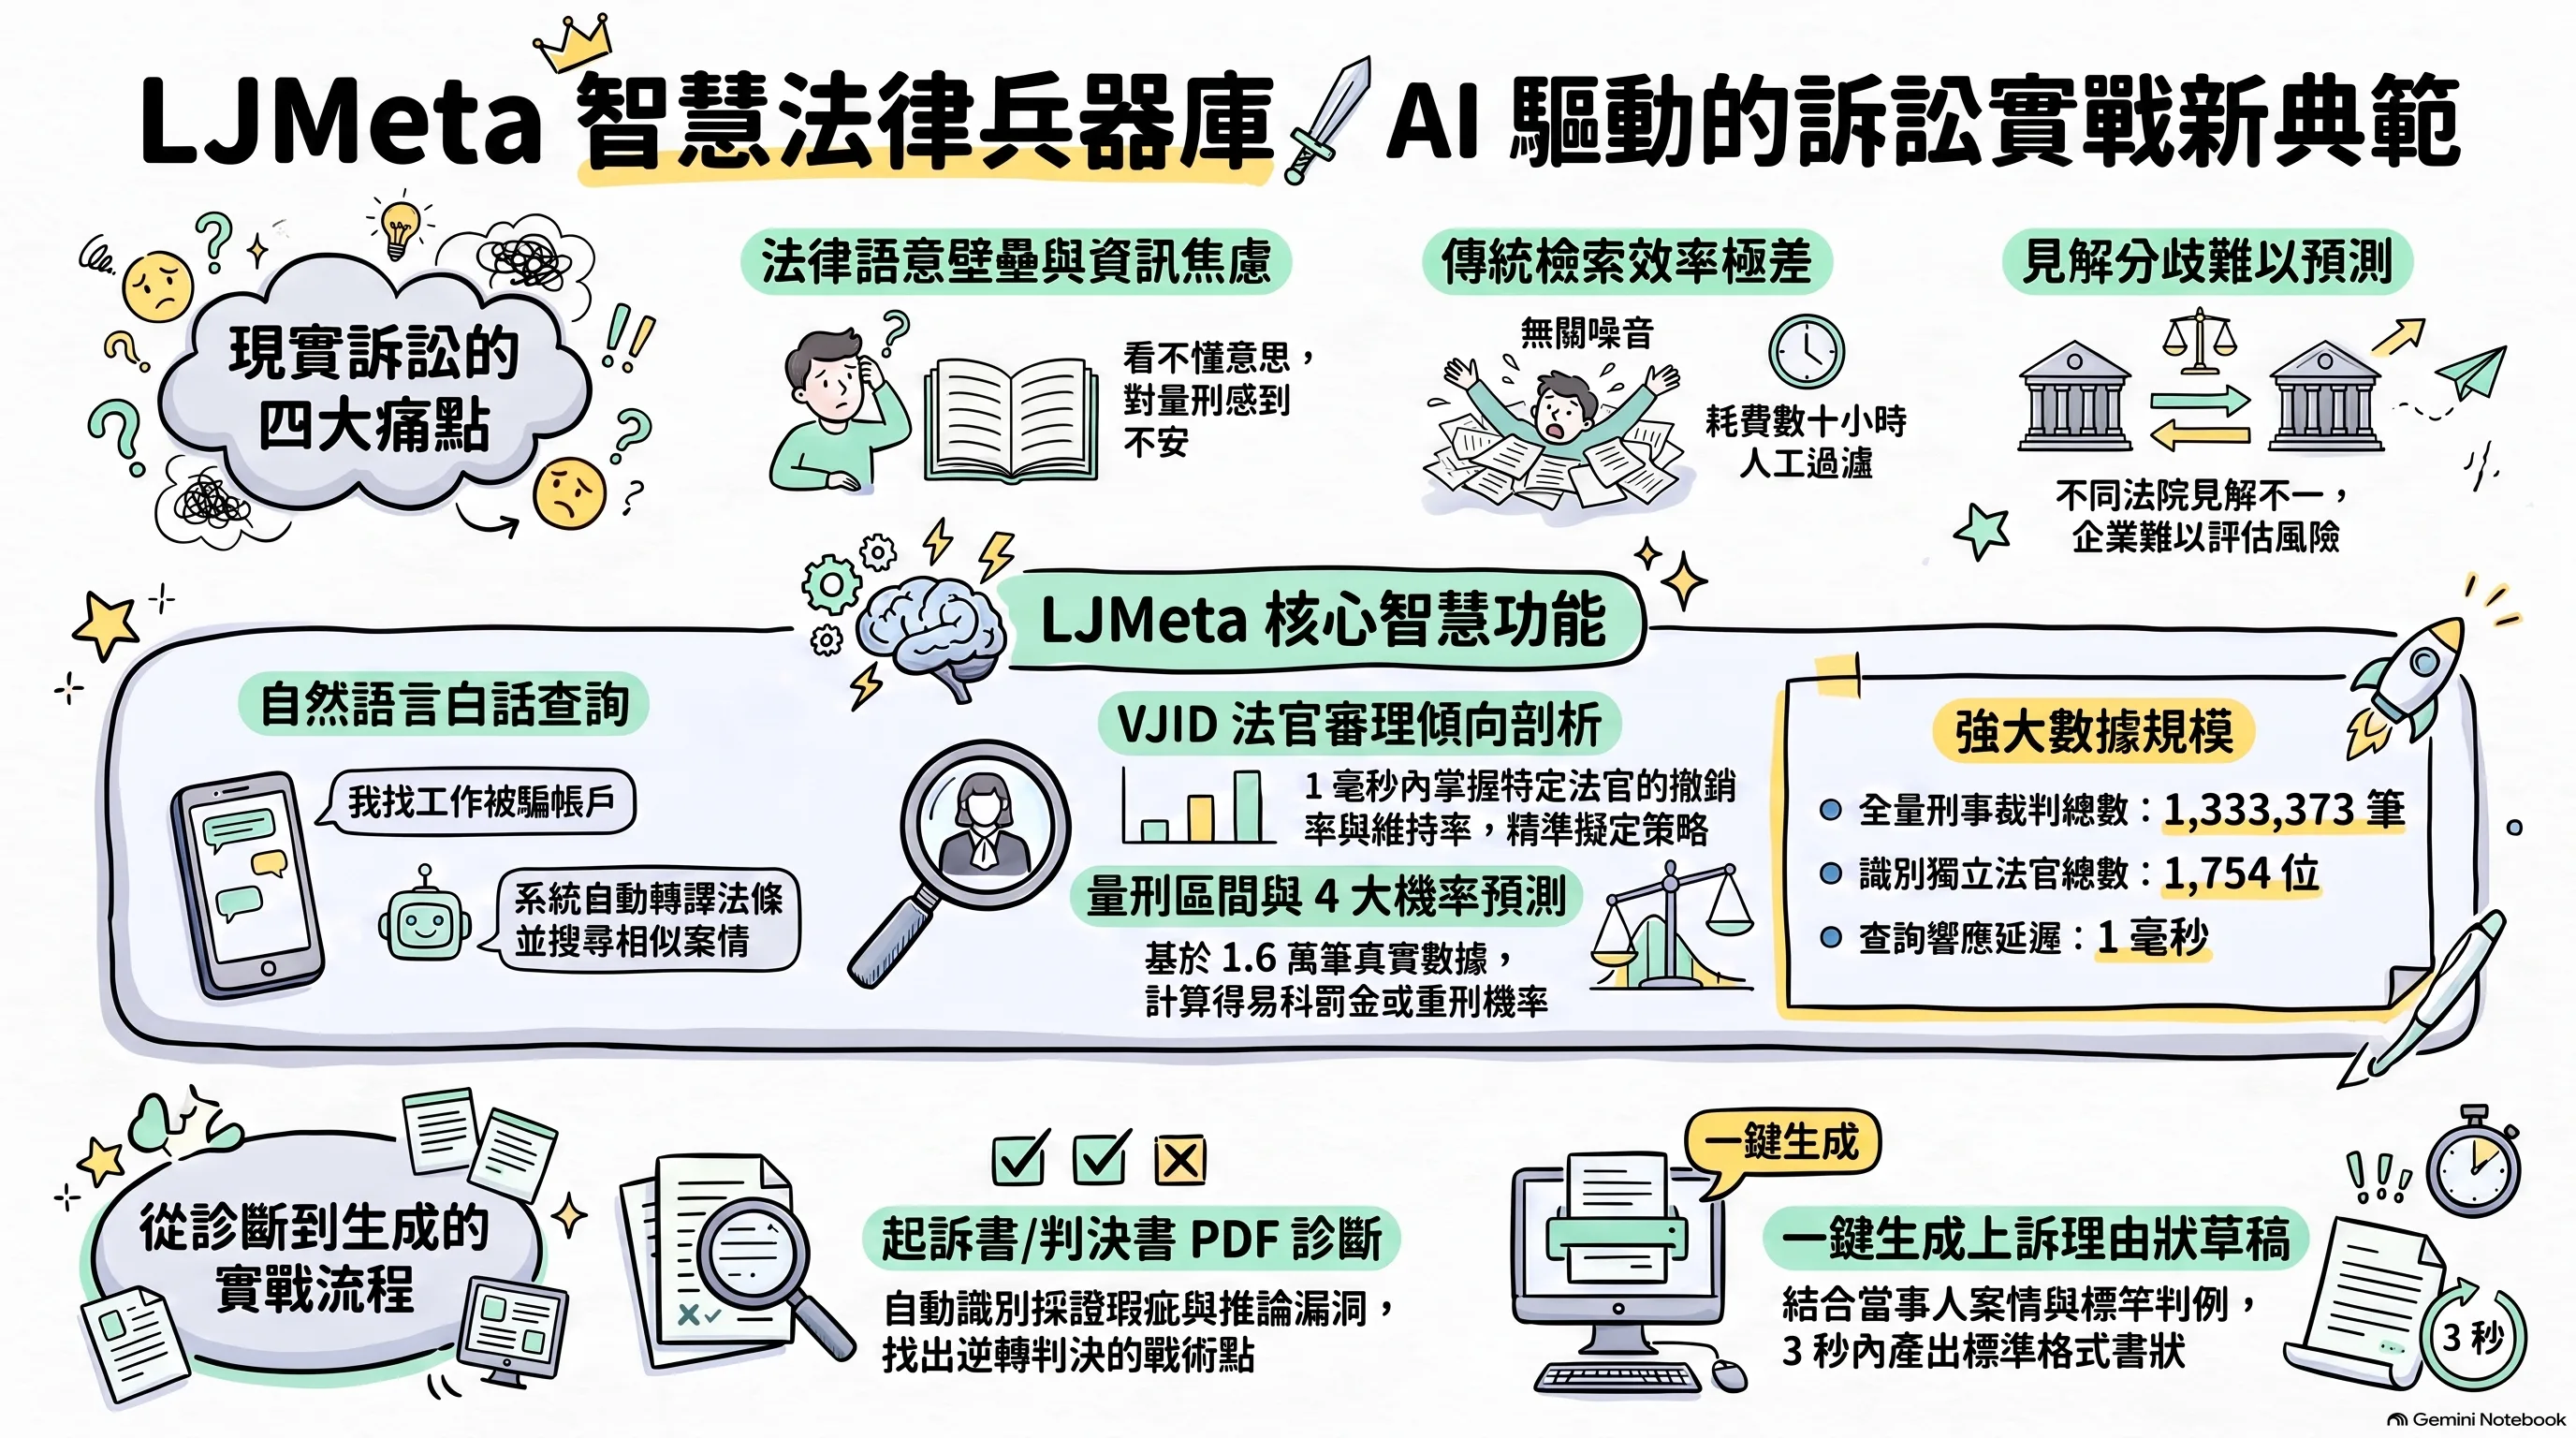
經過一段時間的持續淬鍊,我們正式發布了 LJMeta (Legal Judgment Metadata) v0.6.0 重大更新! 這個版本的的核心宗旨,在於將台灣龐大、艱澀且分散的 1,333,373 筆刑事裁判大數據(100.00% 滿分全涵蓋),轉化為一般民眾、執業律師、企業法務與學者都能隨需隨用、即時解答訴訟爭點的「智慧法律 AI 兵器庫」。 ...
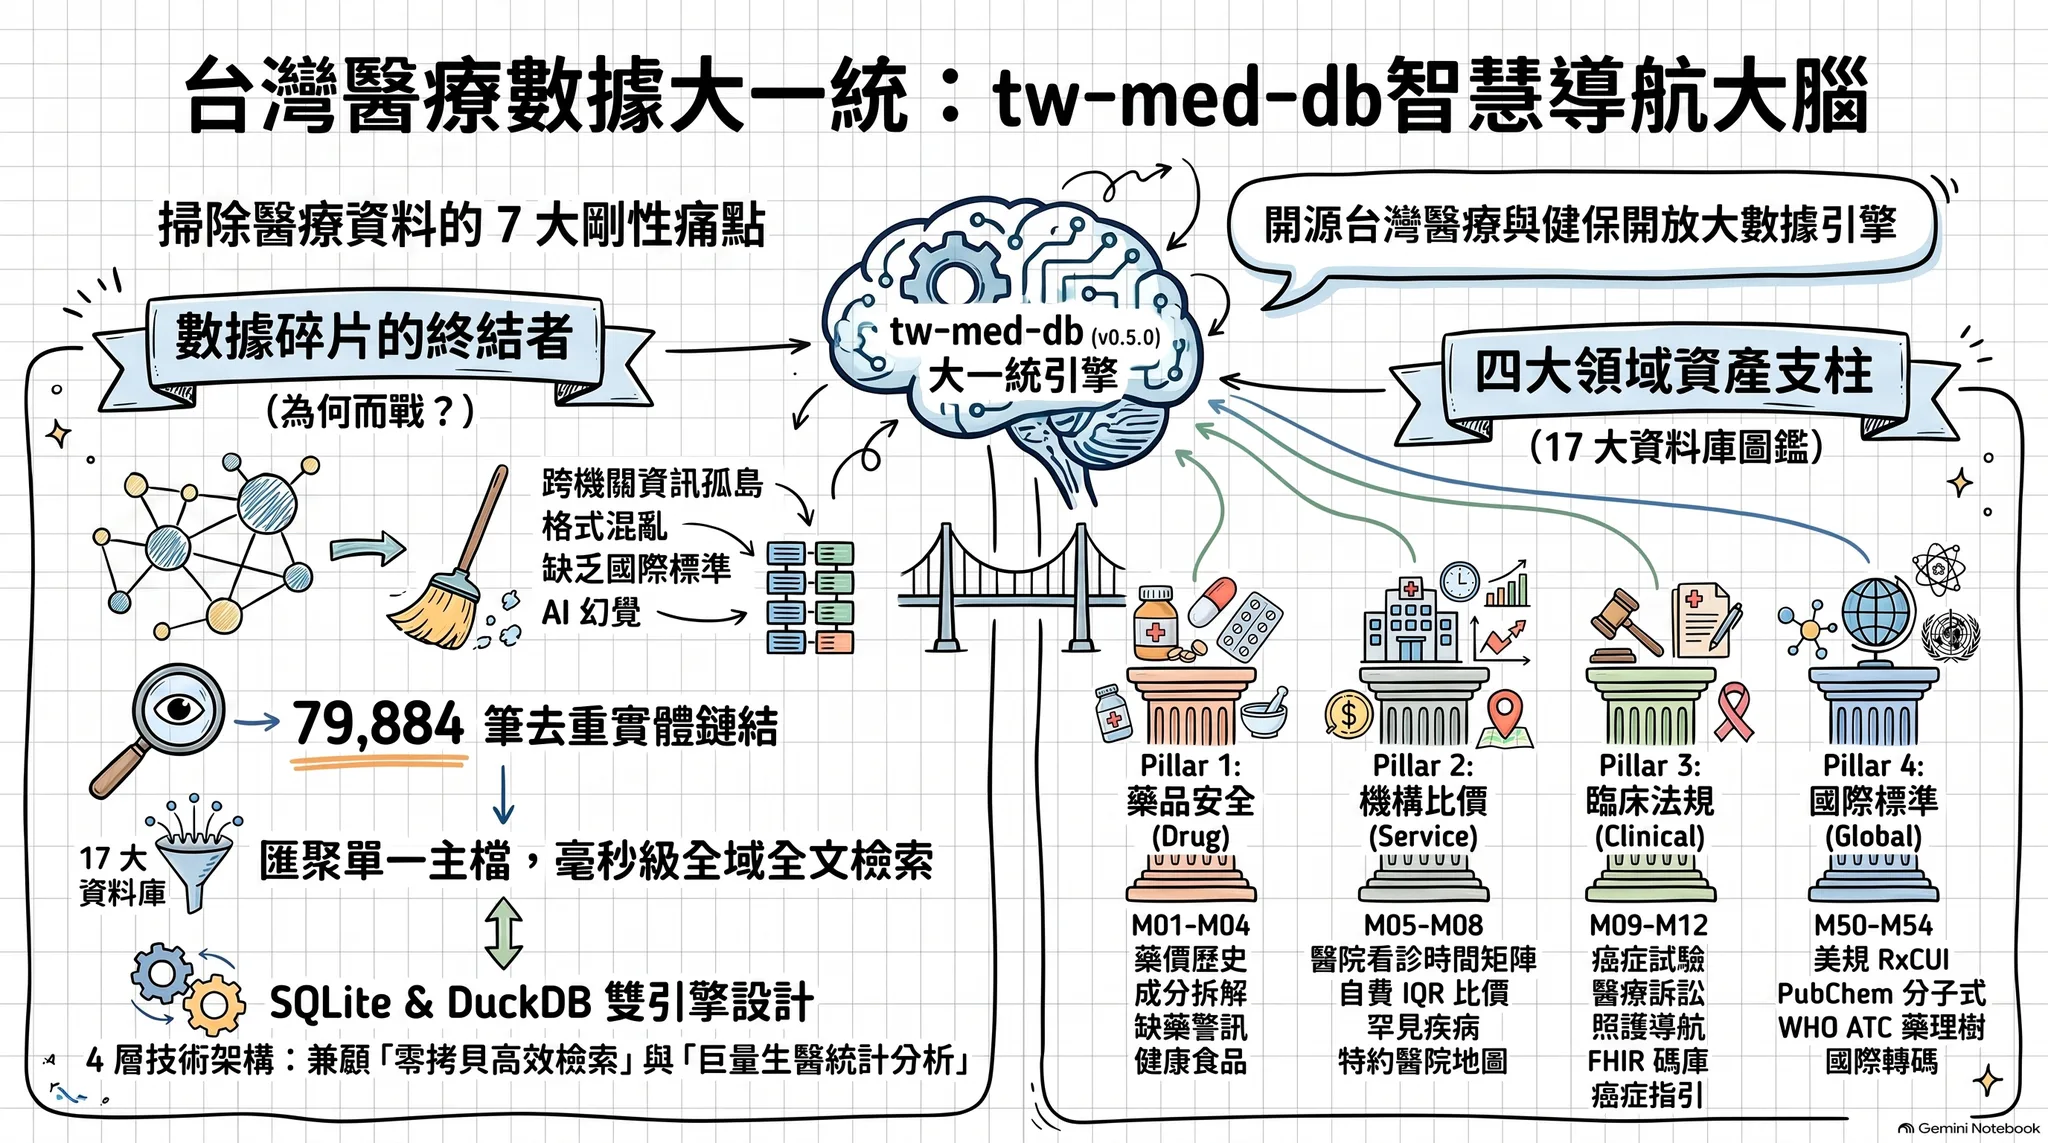
在推動 LLM 與 AI Agent 落地臨床或照護情境時,大家最常遇到、也最頭痛的問題,永遠不是模型不夠聰明,而是**「資料太散、太亂、又太容易讓 LLM 產生致命幻覺 (Hallucination)」**。 ...
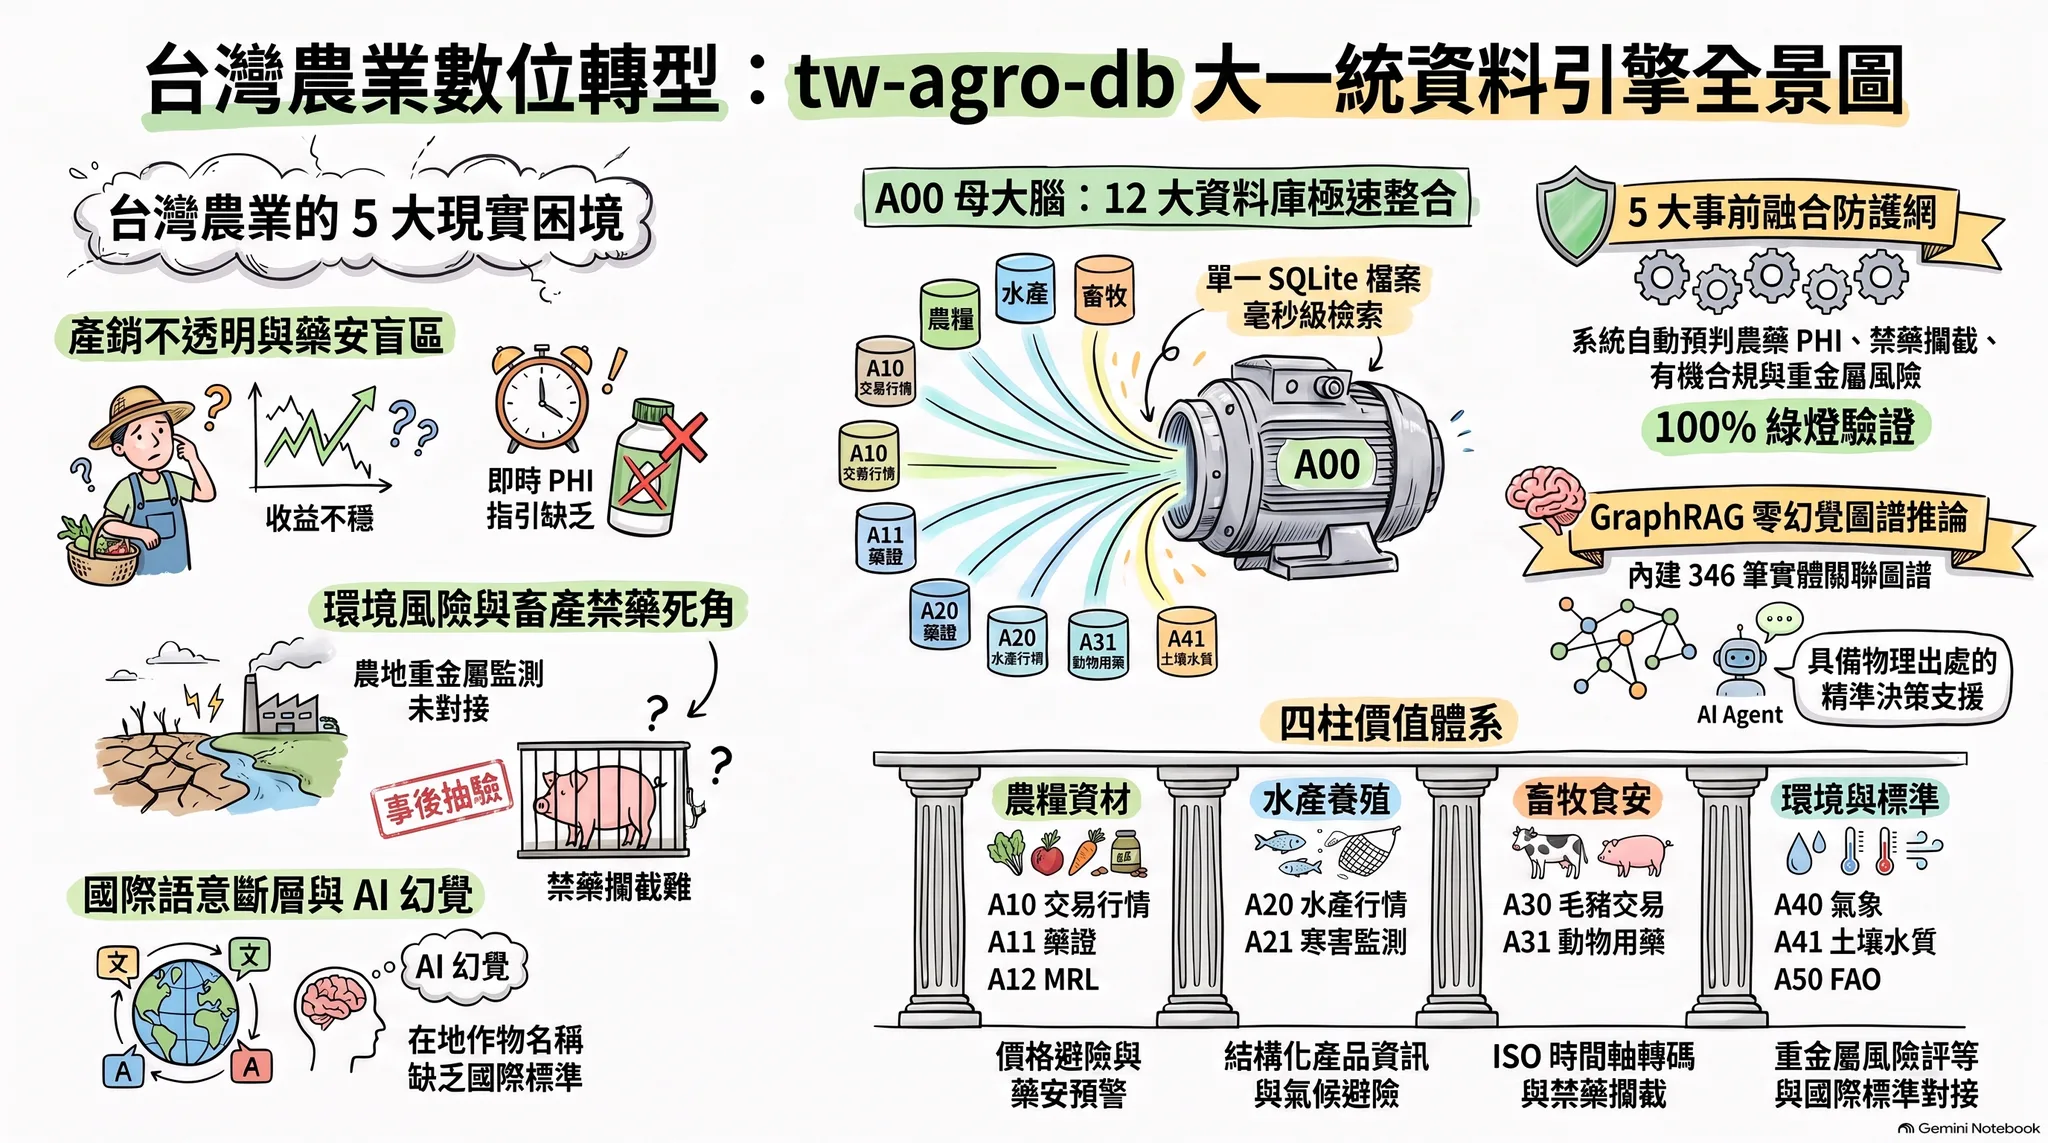
在推動 AI 落地與數據架構的過程中,我們常常遇到一個很真實的痛點:「資料明明都在開放平台上,但要拿來做決策或餵給 AI 時,卻像是在拼一幅散落在十幾個不同政府門戶的拼圖。」 ...