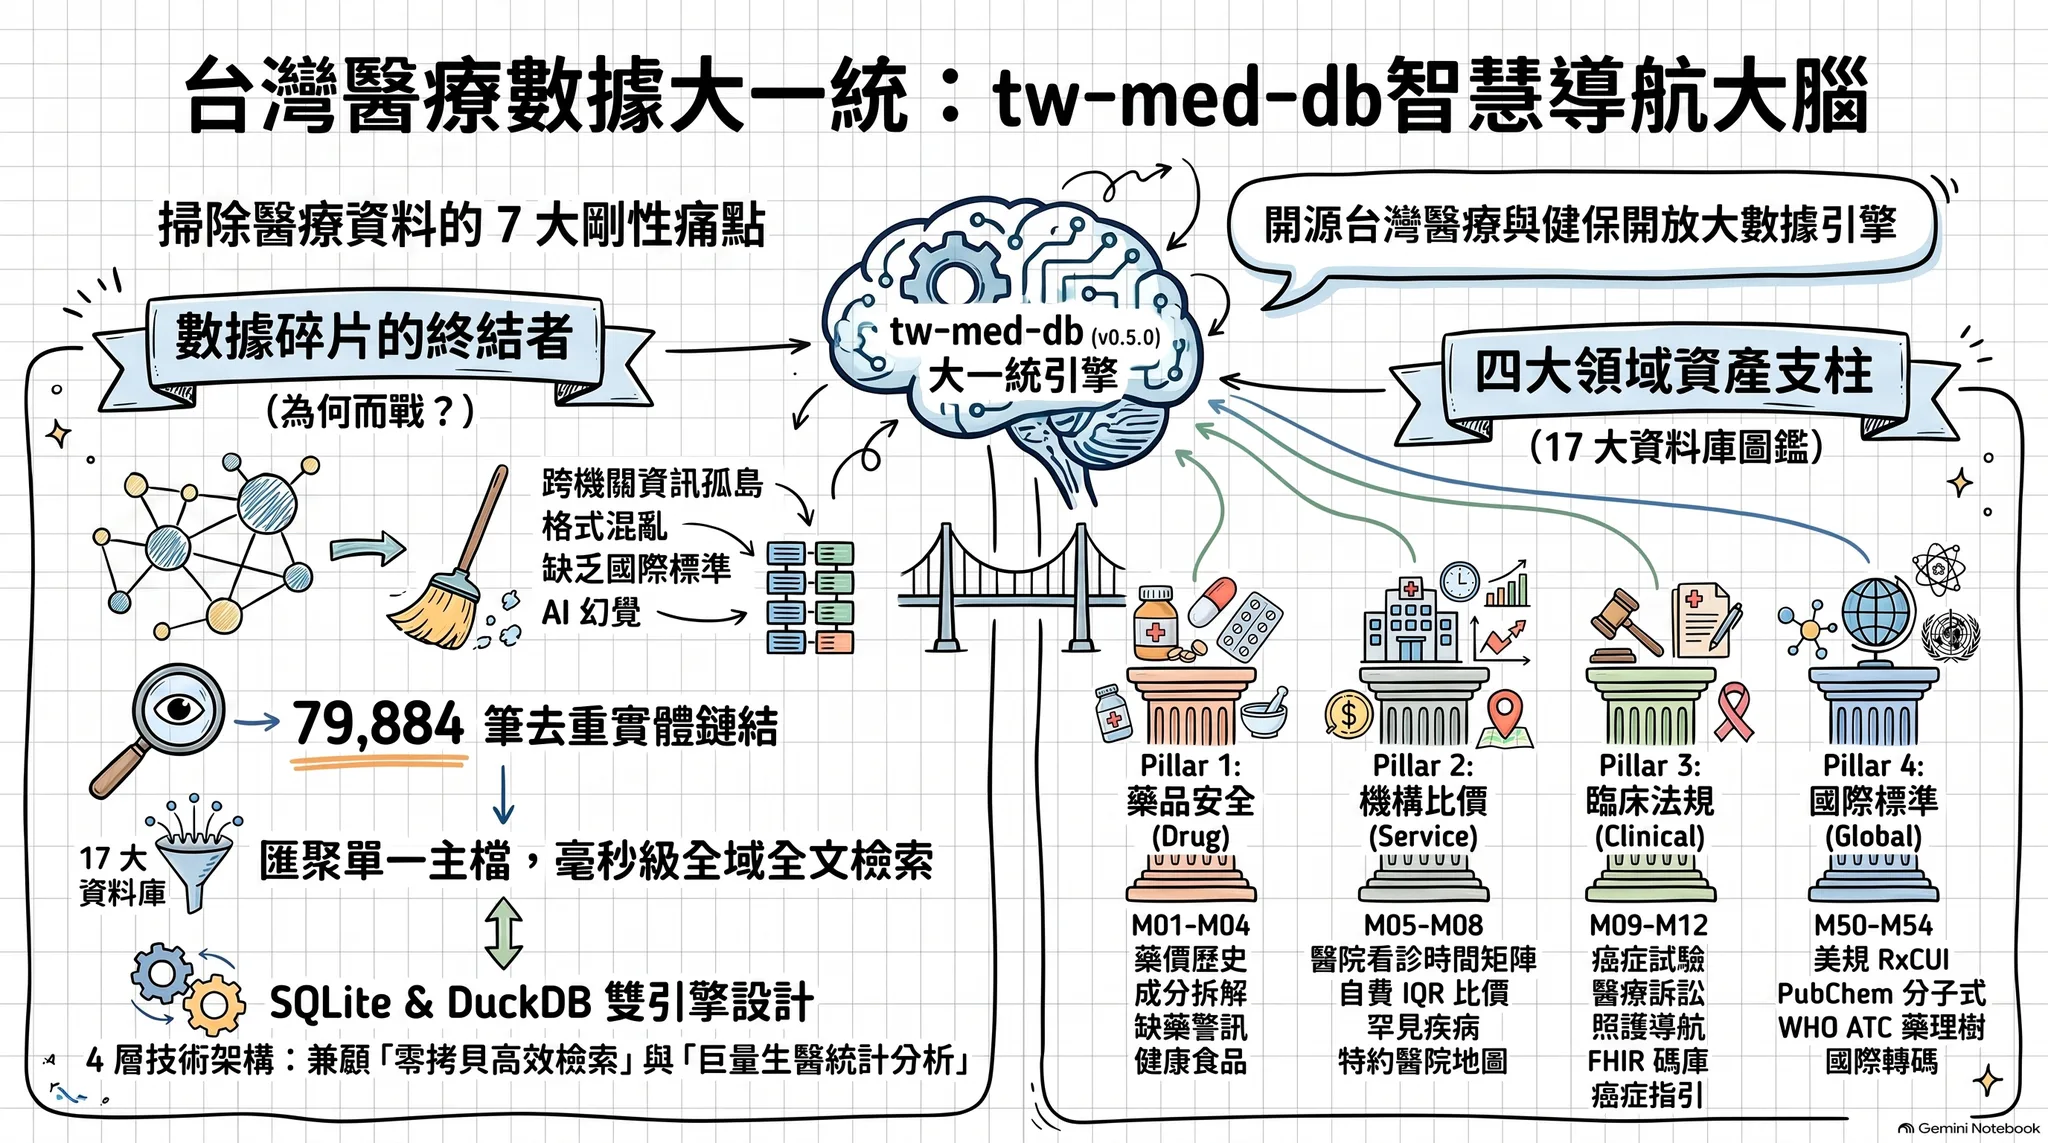
在推動 LLM 與 AI Agent 落地臨床或照護情境時,大家最常遇到、也最頭痛的問題,永遠不是模型不夠聰明,而是**「資料太散、太亂、又太容易讓 LLM 產生致命幻覺 (Hallucination)」**。
過去要查一個藥品的健保價,得去健保署抓 CSV;要看藥品說明書與許可證,得去食藥署 (TFDA) 爬 JSON 與 Zip 檔;想了解最新的癌症臨床試驗,要連結美國 NIH ClinicalTrials.gov;而要比對防範重複用藥或交互作用,又得自己對應 WHO ATC 碼與 RxNorm。這些資料不僅格式歧異(民國年、UTF-8 BOM、ZIP 包裝混雜),而且各自孤立,根本無法讓 AI 代理程式(Agent)進行秒級的跨庫推論。
為了徹底解決這個數據燃料痛點,我們歷經了多個迭代的系統工程淬鍊,正式開源釋出 tw-med-db (台灣醫療與健保開放資料庫引擎)。
- 📦 GitHub 開源專案:https://github.com/wuulong/tw-med-db
這篇文章想跟大家分享 tw-med-db 的架構設計心法、它究竟能做什麼,以及我們如何透過確定性(Deterministic)工程,打造出 0 秒延遲、完全解耦的 AI 生醫數據大腦。
🏛️ 一、 tw-med-db 的 4 層拓撲架構#
tw-med-db 的核心定位,是做為**「100% 確定性、極速 FTS5 檢索、完全解耦 Agent 之開源台灣醫藥健保數據基礎設施」**。
我們不把複雜的邏輯硬塞給 LLM 盲目猜測,而是透過 國內 14 大 DB (M01M14) + 國際 6 大 Gateway (M50M55),總計 20 大獨立子模組,將龐大的生醫數據結構化並一鍵打包為單一標準 SQLite 庫 (med.db) 與 DuckDB OLAP 分析引擎。
                                 ┌──────────────────────────────────────────┐
                                 │  👑 M00 tw-med-db 母專案大數據總指揮官    │
                                 │  (tw-med-cli & Master Integration Brain) │
                                 └────────────────────┬─────────────────────┘
                                                      │
         ┌────────────────────────────────────────────┼────────────────────────────────────────────┐
         │ (國內 14 DB 實體特徵對合 M01~M14)                                                       │ (國際 6 DB 跨國標準對合 M50~M55)
         ▼                                                                                         ▼
┌──────────────────────────────────────────────────────────┐             ┌──────────────────────────────────────────────────────────┐
│ 🇹🇼 國內 14 大 DB 進階特徵採納                              │             │ 🌐 國際 6 大 DB 標準與重症數據採納                       │
│ • m00_entities (全域實體統一 ID)                         │             │ • m00_global_rxcui_map (M01 健保碼 ➔ M50 RxCUI)          │
│ • m00_hospital_capabilities (M05+M07+M08+M14 防疫醫院)   │◄───────────►│ • m00_global_atc_tree (M02 國內切片 ➔ M53 WHO正本樹)     │
│ • m00_price_benchmarks (M01+M06+M07 價格基準)             │             │ • m00_global_taiwan_trials (M09 癌症 ➔ M51 NIH試驗)      │
│ • m00_clinical_paths (M09+M11 臨床路徑)                  │             │ • m00_global_chem_genetics (M02 成分 ➔ M52 PubChem)     │
│ • v_m14_epidemic_hospital_mesh (M14據點 ➔ M05醫院)       │             │ • m00_fhir_converter_hub (M12+M13 ➔ M54 FHIR/LOINC)      │
│                                                          │             │ • m55_mimic_cache (M55 MIT/BIDMC 重症 31 表與 SOFA)      │
└──────────────────────────────────────────────────────────┘             └──────────────────────────────────────────────────────────┘
系統整體劃分為 4 層拓撲(Layer 0 ~ Layer 3):
- Layer 0 (Raw Data & ETL Clean):自動化下載、BOM 移除、解壓與 ISO 8601 時間標準化,清洗全台 6.6 萬筆藥證、6.6 萬筆醫材、18.7 萬筆疾管署據點與 22.4 萬筆健保價資料。
- Layer 1 (Physical SQLite & Submodules Topology):採用子模組獨立設計,20 個子模組(如
m01_tw_drug_db)擁有自己的schema.sql、etl.py與metadata.json,透過build_master_db.py以 SQLiteATTACH DATABASE秒級實體合成母庫med.db。 - Layer 2 (Master Views & Global FTS5 Neural Mesh):
- 建立 33.1 萬筆實體倒排總索引 (
fts_med_global),提供 $< 0.005$ 秒的全庫文字命中。 - 打造大一統 View(如
v_master_drug_safety_mesh與v_m14_epidemic_hospital_mesh),一鍵貫通「藥品 ➔ 主成分 ➔ 給付規定 ➔ 特約醫院 ➔ 疫苗據點」。
- 建立 33.1 萬筆實體倒排總索引 (
- Layer 3 (Agentic Intelligence & FHIR Gateway):提供純 Python 的確定性 Scorer(如
drug_scorer.py進行 DDI 重複用藥比對),並提供tw-med-cli convert-fhir白皮書閘道,0 秒將實體轉譯為國際標準 HL7 FHIR R4 JSON Payload。
📦 tw-med-db 全域 20 大實體子模組清單對照表#
整個引擎收錄了 國內 14 大子模組 (M01~M14) 與 國際 6 大 Gateway (M50~M55):
| Pillar 分類 | 模組代號與 Repository 名稱 | 資料源與實體庫規模 | 核心價值與 Agentic 應用場景 |
|---|---|---|---|
| Pillar 1: 藥品安全 | M01 tw_drug_db | TFDA 藥證 + 健保藥價 (6.6萬筆) | 台灣健保藥品品名、適應症、健保價與藥證狀態。 |
M02 tw_ingredient_map_db | WHO ATC + 主成分字典 (7,713筆) | 主成分中英文對照、ATC 藥理分類樹與同成分學名藥比對。 | |
M03 health_supp_db | TFDA 健康食品許可證 | 健康食品成分、功效宣稱與藥食交互作用防禦。 | |
M04 drug_shortage_alert | 食藥署缺藥與藥品回收警訊 (1,710筆) | 實時缺藥通報、回收批號警訊與同效益替代用藥比對。 | |
| Pillar 2: 機構比價 | M05 tw_hospital_db | 健保特約醫事機構名冊 | 全台特約醫院、診所專科地圖與層級評鑑資料。 |
M06 nhi_payment_db | 健保給付規定與自費比價 | 健保事前審查給付規定條文與自費醫材比價網。 | |
M07 nhi_procedure_db | 健保處置與手術碼庫 | 健保處置項目、手術碼與點數申報標準。 | |
M08 rare_disease_db | 國健署罕見疾病與罕藥名單 | 罕見疾病認定、孤兒藥名冊與專案補助。 | |
| Pillar 3: 臨床法規與照護 | M09 oncology_meta | ClinicalTrials.gov + NCCN | 癌症標靶指引與在台招募中之 NIH 臨床試驗。 |
M10 med_legal_db | 司法院 ljmeta 醫療判決 | 醫療糾紛過失裁判、專庭判例與防禦性醫療提示。 | |
M11 patient_journey_db | 病患全程臨床照護導航 | 疾病特定病程階段、治療決策樹與病患導航路徑。 | |
M12 med_lab_fhir_db | TW Core IG FHIR + LOINC | LOINC 檢驗碼對照與抽血/檢驗報告 FHIR 結構化解析。 | |
M13 tw_med_device_db | TFDA 醫療器材許可證 (6.6萬筆) | 醫療器材說明書 PDF、許可證字號與同級醫器替代品比對。 | |
M14 cdc_epidemic_db | CDC 疾管署疫苗與據點 (18.7萬筆) | 流感抗病毒藥劑診所、疫苗接種據點與 Haversine 圈環搜尋。 | |
| Pillar 4: 國際標準與重症 | M50 rxnorm_db | 美國 NLM RxNorm | 台灣健保藥碼 ➔ 美國 RxNorm RxCUI 國際碼映射。 |
M51 clinical_trials_gov | 美國 NIH ClinicalTrials.gov | 全球三期臨床試驗與在台招募機構數據對照。 | |
M52 pubchem_db | 美國 NCBI PubChem | 化學分子結構式 (SMILES, InChIKey) 與 PubChem CID 鏈結。 | |
M53 who_atc_db | WHO ATC/DDD Centre | WHO 官方 5 階解剖學治療學化學分類樹與 DDD 劑量。 | |
M54 twcore_fhir_db | HL7 FHIR R4 & LOINC | 國際醫療數據交換標準與 TW Core Profile 規範對照。 | |
M55 mimic_iv_db | 美國 MIT/BIDMC MIMIC-IV 重症 31 表 | 重症 SOFA/NEWS2 警訊、Sepsis-3 標籤與 ICU 照護軌跡。 |
⚡ 二、 tw-med-db 究竟能做什麼? 4 大實體應用場景#
有了這個開源庫,無論是人類工程師透過 CLI,還是 AI Agent 透過 MCP Server,都能發揮驚人的威力:
1. 0.005 秒全域跨庫神經網檢索 (fts_med_global)#
以往要搜尋一個關鍵字,常常面臨欄位匹配不上的問題。tw-med-db 建構了 33.1 萬筆倒排索引,輸入 "美麗沙而" 或 "流感抗病毒":
python src/cli/main.py search "美麗沙而" --db db/med.db可在 5 毫秒內同時列出:
M01健保處方藥 (藥碼DHY01400004100)M13醫療器材許可證 (許可證內衛成製字第000041號,含製造廠與官方 PDF 說明書連結)
2. 確定性處方比對與用藥安全防禦 (drug_scorer.py)#
不用依賴概率型的 LLM 算術,我們用純 Python 寫了確定性比對器。輸入兩組健保藥碼,系統會自動抽取其 WHO ATC 碼與主成分:
- 秒級列出重複用藥風險(同一成分或同類藥理)。
- 核對健保給付章節與自費比價金額。
- 回傳結構化 JSON,成為 AI Agent 最值得信賴的安全護欄 (Safety Rail)。
3. 防疫據點與院所地理空間對合 (v_m14_epidemic_hospital_mesh)#
整合 M14 疾管署 18.7 萬筆流感抗病毒藥劑與疫苗合約診所據點,並與 M05 特約醫事機構、M12 LOINC 檢驗碼解耦對合:
- 支援 Haversine 算式進行 0 秒記憶體內經緯度半徑圈環比對 (
m14 nearby)。 - 輸入經緯度,自動列出周邊 3 公里內兼具特定專科與流感/疫苗備量的特約醫院。
4. 國際醫學標準對接與 HL7 FHIR R4 轉換#
tw-med-db 不只適用於台灣在地情境,更向下架構了國際 5 大 Gateway:
M50RxNorm (台灣健保碼 ➔ 美國 RxCUI 映射)M51ClinicalTrials.gov (在台招募中之 NIH 臨床試驗)M52PubChem (化學結構式 SMILES & InChIKey)M53WHO ATC (官方 5 階解剖學治療學化學樹)M54TW Core IG FHIR (將本地實體一鍵轉為符合國際規範的 FHIRMedicationRequest或DevicePayload)
🛠️ 三、 系統工程實踐:獨立單元測試與 100% 獨立運行#
在寫 tw-med-db 的過程中,我們堅持了一個硬性規定的系統工程原則:「每一個子模組必須 100% 獨立,且測試必須能獨立運行 (Self-Referential Proof)。」
- 雙層 Metadata 治理:專案層級維護聚合的
metadata.json;Table 端的attributes_json第一個 Key 寫入版號"_v": "1.0.0",方便未來長遠維護。 - 100% 獨立單元測試:例如
test_m13_tw_med_device_db.py與test_m14_cdc_epidemic_db.py獨立運作,測試函式對齊VAL-001~VAL-004(主鍵完整性、FTS5 對齊度、CLI 功能、版號規範),並將詳細執行日誌寫入logs/LOG_MXX_TEST.log。 - 全庫 Doctor 健康診斷:隨時執行
python src/cli/main.py doctor,系統會自動掃描全庫實體表、檢視與倒排索引,確保資料庫處於[PASS]健康狀態。
💬 四、 哈爸碎碎念:人機協作下的數據基礎設施#
過去做醫療資訊系統,光是處理各機關格式不一的 Open Data、移除 UTF-8 BOM 碼、轉民國年,就消耗掉工程師絕大部分的精神。
這次透過 GenAI 與系統工程 (System Engineering) 方法論的結合,我們把這 19 個領域庫從採樣、洗資料、設計 View、寫 FTS5 索引、到產出獨立單元測試 (independent unit tests) 與 7.8 萬字的白皮書合訂本(TW_Med_DB_Whitepaper_Full.md),全都在流暢的人機協作中完成。
哈爸的心得: AI 時代的基礎建設,不該是把未經整理的亂七八糟文字直接丢給 RAG。「乾淨、結構化、有 FTS5 與拓撲視圖的 SQLite,才是 AI Agent 最強大、最省 Token 的外掛大腦。」
tw-med-db 現已正式開源,歡迎關心台灣數位健康、生醫資訊、LLM Agent 應用的朋友一起來玩,把台灣優秀的醫療數據變成世界級的 AI 燃料!
- 🔗 GitHub 專案位址:https://github.com/wuulong/tw-med-db
AI 協作聲明: 本文由筆者提供專案開發歷程、架構心法與實戰數據,由 AI 助手 Antigravity 彙整架構與修辭。結合了 tw-med-db 的系統工程規格與哈爸筆記的敘事風格,展現人機協作下的軟體架構成果。