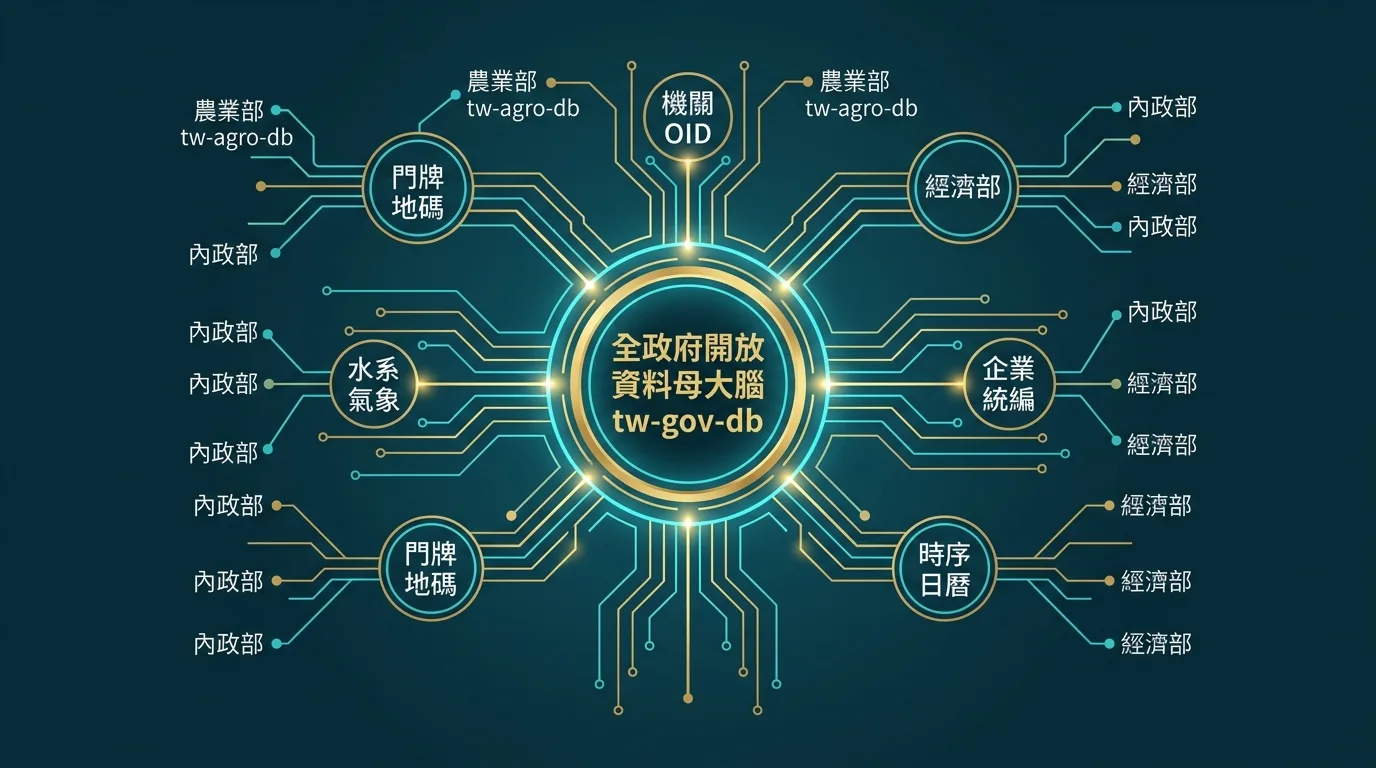
這幾天,我們正式開源釋出了 《全台灣政府開放資料通用基石圖鑑》(tw-gov-db / 代號 GOV-300) 專案庫與配套開源圖書白皮書:
- 📦 GitHub 專案庫:👉
wuulong/tw-gov-db - 📘 全書大一統合訂本白皮書:👉
FULL_BOOK_TAIWAN_GOV_DB.md
這篇文章不談艱深的代碼,我想從一個開發者的心路歷程,分享為什麼會有這個專案、為什麼當初做完農業部之後突然發現「沒有頭不行」,以及這個「母大腦」的架構到底是如何被逼著設計出來的。
一、 倒逼出來的頓悟:做了農業部,才發現「沒有龍頭,何來群龍?」#
這場探索的起點,其實是我們先前開發的農業部開放資料庫——tw-agro-db。
當時我們興高采烈地把農業部的農藥許可證、作物行情、氣象寒害、休閒農場與農漁會資料,通通整理成了極致的對照網路。測試跑得很順、資料也很豐富,但當我們試圖再往前跨一步——想讓 AI 結合內政部的國土門牌、經濟部的公司登記、甚至是環境部的水質監測時——我們撞上了一道非常沉重的牆。
我們發現:如果每一個部會(農業部、內政部、經濟部)都自己搞一套基礎設施,最後只會變成幾十個各自強大、卻互不相通的「數位割據部落」。
在農業部專案裡,我們為了對齊一個機關別名、轉換一個舊民國年、或是反查一個郵遞區號,寫了大量的底層轉換工具。如果不把這些通用工具抽離出來,下一個要做內政部或經濟部的人,就得把這些輪子重新造一遍。
那一刻我突然頓悟:在整個全台灣政府開放資料生態系裡,如果沒有一個統一的「母大腦龍頭」,所有的部會子資料庫就只是一群無法連鎖反應的散兵游勇。
這就是為什麼我們決定暫緩擴建更多部會,回過頭來打造 tw-gov-db(GOV-300)這個全政府母大腦基石庫。
二、 這個頭該怎麼起?「母大腦」架構是如何被設計出來的#
既然決定要起這個頭,下一個核心問題就是:這個母大腦到底該長什麼樣子?
它絕對不能包山包海去干涉各部會自己的業務邏輯,但也絕對不能流於空洞。經過反覆的架構演繹,我們決定將 GOV-300 定位為**「通用基石與路由調度中心」**,並設計了三大核心支柱:
1. 五大「空間與時空通用錨點」(The 5 Pillars)#
我們不存各部會的細節資料,我們只凝練全全台灣資料運作最底層的五個共通語言:
- 機關 OID 身分:把全台近 8,000 個官方機關與發布別名對齊。
- 門牌與地籍碼:提供 6 碼行政區劃與 3+3 碼門牌區號即時反查。
- 水系與氣象測站:鎖定 122 條國家水系與 450 個氣象/水質監測站。
- 企業與 NPO 統編:快取全台上市企業與 2.3 萬筆農漁會法人。
- 時間與時序:將舊民國年與辦公日曆 100% 歸位至標準 ISO-8601。
2. 三層式跨專案導航與連線介面(DomainRegistryResolver)#
母大腦如何指揮子專案?我們設計了三層式的解耦連線介面:
- CLI 命令級:母大腦可以跨專案發動子專案的命令行工具(如發動農業部的
pesticide或frost-alert)。 - Core DB 直連級:透過高效的 SQLite 直連與跨庫 View 穿透,讓跨部會 JOIN 查詢在毫秒級完成(實測 P99 延遲小於
0.01ms)。 - Python SDK 級:動態加載各部會的 Adapter 類別,維持輕量與隔離。
3. 雙向 Prompt 契約協議(Bi-directional Prompt Contracts)#
為了讓多個 AI Agent 在不同對話視窗、不同專案庫之間協同作業,我們在架構中設計了實體的「交接 Prompt 檔案」:
- 母大腦產出
PROMPT_TO_SUBMODULE_[CODE].md帶領子專案 AI 開工。 - 子專案完工後產出
PROMPT_TO_MASTER_G300.md回報母大腦。 人類開發者不再需要手動寫對接細節,而是拿著這份實體契約 Prompt 在視窗間傳遞,實現多 Agent 的無縫接力。
三、 寫在最後:從龍頭起步,迎向群龍水起#
tw-gov-db 的釋出,標誌著台灣開放資料從「單一部會垂直深耕」跨入「全政府通用對接」的新階段。
現在,頭已經起了。農業部 tw-agro-db 已成功與母大腦達成 100% 綠燈合龍;接下來,內政部(GOV-A13)、經濟部(GOV-A09)等子專案,都可以直接複製我們提供的標準起步藍圖模板(template_blueprint/),在幾分鐘內啟動並連結至這個母大腦。
歡迎大家來逛逛我們的 GitHub Repo,或是閱讀那本收錄了全架構與 14 張拓樸圖的白皮書合訂本:
- 📦 GitHub 專案庫:👉
wuulong/tw-gov-db - 📘 全書大一統合訂本白皮書:👉
FULL_BOOK_TAIWAN_GOV_DB.md
這是一套為生成式 AI 與 Agentic AI 世代打造的台灣數位基礎設施。龍頭已就位,期待接下來與大家一起迎向群龍水起的開放資料新時代!
AI 協作聲明: 本文由哈爸(Wuulong)口述原始思考脈絡、倒逼過程與架構設計企圖,並由 AI 助手整理、修飾語氣與編排 Hugo 部落格格式。全篇內容反映實際專案開發之經驗與決策成果。